
- UseCase
- 製造
第一三共、エージェンティックAIを創薬研究の戦力へ実験の自動化基盤を構築
「AWS Summit Japan 2026」より、研究開発本部 研究統括部 スマートリサーチ第一研究所長の岡本 敦之 氏
実験プロセスを自動で回す仕組みを確立する
プラットフォームの中心となるスマートラボは、複数拠点にまたがる実験プロセスの自動化を推進する仕組みだ。その要点を岡本氏は「(1)『ワークセル』によるend-to-endの実験自動化、(2)『Experiment as Code(実験プロセスのコード化)』、(3)データの自動キャプチャと一元管理、の3点」に整理する。
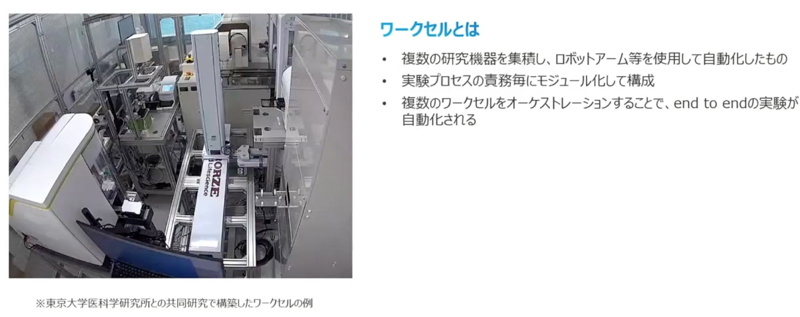
ワークセルは、一定の空間内に複数の研究機器を集積し、ロボットアームなどで一連の作業を自動化したユニットを指す(図2)。複数の機器や処理を連携させ、工程全体を制御することで、実験を端から端へと自動化する考え方だ。「人手を減らせば再現性が高まり、24時間365日の運用が現実になる」(岡本氏)とする。
Experiment as Codeは、実験プロセスをプログラムとして定義する考え方である。コード化された実験手順をクラウドに実装するため、研究者はラボの場所を問わずに同じ実験を実行できる。
データの自動キャプチャーと一元管理では、ワークセルから生み出されたデータを活用できるようにする。メタデータが付与された状態でシステムに取り込み、グローバル標準の「FAIR(Findable:見つけられる、Accessible:アクセスできる、Interoperable:相互運用できる、Reusable:再利用できる)原則」に沿って蓄積する。
スマートラボ構想は、段階的かつグローバルに広げている。先行して米サンディエゴの拠点にパイロットラボを構築し、その知見を日本にも移植した。ワークセル群を統合制御するソフトウェアはクラウド上にあるため「研究のメインサイトである『品川研究開発センター』(東京都品川区)と『葛西研究開発センター』(東京都江東区)を合わせた3拠点でAWS環境を共有している」(岡本氏)という。
データを作った側が責任を持つデータメッシュの基盤を構築
データ基盤の整備では、分散型データ管理の手法である「データメッシュ」を採用している。データメッシュは「データを生み出す側(データプロデューサー)が自らオーナーシップを持ち、信頼性を担保したデータを『データプロダクト』として利用者に提供する」(岡本氏)運用形態を指す。
データメッシュは利用側である研究者にとっての利点も大きい。岡本氏は「中央のデータチームを介さずに、必要なときにいつでもデータにアクセスできるため、中央で作業のボトルネックにならない」と説明する。さらにデータプロデューサーと直接やり取り可能なため「目的に合致した本当に欲しいデータにたどり着ける」(同)。
データ基盤のバックエンドには、統合開発環境「Amazon SageMaker Unified Studio」やデータ管理サービス「Amazon DataZone」などを採用している(図3)。
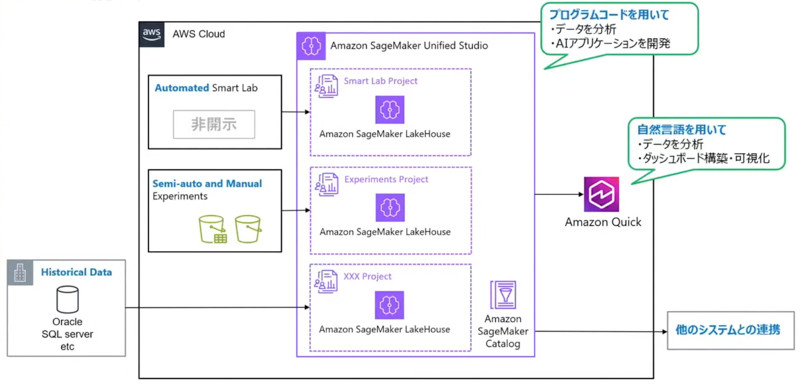
一方では、創薬研究のすべてを自動化することは不可能でもあり、人手による実験も依然として残る。そのため「手作業から生まれるデータも、スマートラボの自動生成データと同等に扱えるよう、クラウド上に蓄積する仕組みを構築中だ」と岡本氏は強調する。
さらに、既存のオンプレミス環境で稼働する稼働するレガシーシステムのデータ統合も大きな課題の1つだ。これに対してはUnified Studioで、オンプレミスに残るデータのうち必要な部分のみをクラウド上に複製・同期し、ほかのデータと統合して扱う。
UI(User Interface)面では、AIアシスタント「Amazon Quick」により研究者が自然言語でデータを扱える環境を目指している。今後はオープンなテーブル形式「Apache Iceberg」などとの連携も視野に、創薬に向けたデータ活用の幅を広げていく構えだ。