- UseCase
- 製造
東洋紡、現場が言葉を“教えて育てる”AIエージェントで製造の知見を引き出す
「AWS Summit Japan 2026」より、TX・業務革新総括部の坂倉 広也 氏
正確性を高めるため、打ち手として(1)検索方式の見直し、(2)取得件数の拡張、の2つを用意した。
検索方式の見直しでは、キーワード検索と、言葉の意味や文脈の近さで探すセマンティック検索を組み合わせたハイブリッド検索を明示的に指定し、正確性スコアを0.57へ引き上げた。「現場の独自用語には“B1A3”のように数字とアルファベットで工場や工程を表す略称が多く、一般的な意味を持たないため、セマンティック検索だけでは捉え切れなかったから」(坂倉氏)だ。
取得件数の拡張では、検索で取得するソース数の上限を5件から60件へ広げ、正確性スコアを0.86へ高めた。社内文書には「『B1でトラブル発生、XX時に対応』といった短い記録が多く、単体では“B1”が何を指すのか分からない」(坂倉氏)という。取得件数を増やして、周辺の記録から前後のコンテキスト(文脈)を補う。
8割を超える正確性で現場に展開すると「反応が『使えそう』に変わった」と坂倉氏は強調する。さらに「結果まで入力すれば良い回答が出てきそうだ」「当時どういう現象だったかの記録も必要だ」と、データ構造に目を向ける声も出始めた。無関心だった現場が関心を持ち「データを残すことや表記をそろえることがAI技術の回答品質に効くのだと、現場自身が気付き始めた」(同)のである。
「聞いて・探して・答える」から知識が育つ仕組みへ
もっとも、定着までには新たな3つの壁があった。未知の用語が次々と現れる「現場用語の壁」、用語が増えるほど検索ノイズが増える「検索ノイズの壁」、改善を回し続ける仕組みがない「継続改善の壁」である。
従来のRAGは「聞いて・探して・答える」という一方向の検索体験にとどまる。壁を解くために坂倉氏らは全体を「現場の言葉を理解し、確認し、蓄積して改善へ戻す」6ステップのサイクルとして組み直し、AIエージェントが自律的に検索や判断を重ねる「エージェンティックRAG」へと発展させた(図2)。
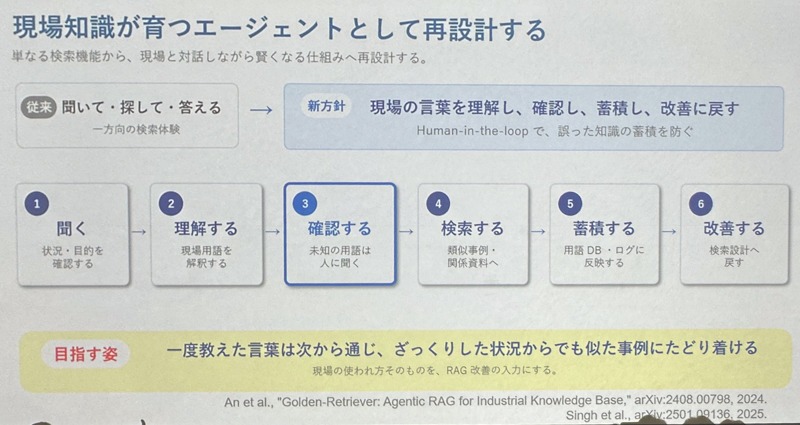
これは「現場での使われ方そのものを、RAGを改善する入力に変える発想」(坂倉氏)だ。利用者が質問の中で教えた用語はデータベース(DB)に蓄積し、次の検索に生かしていく。
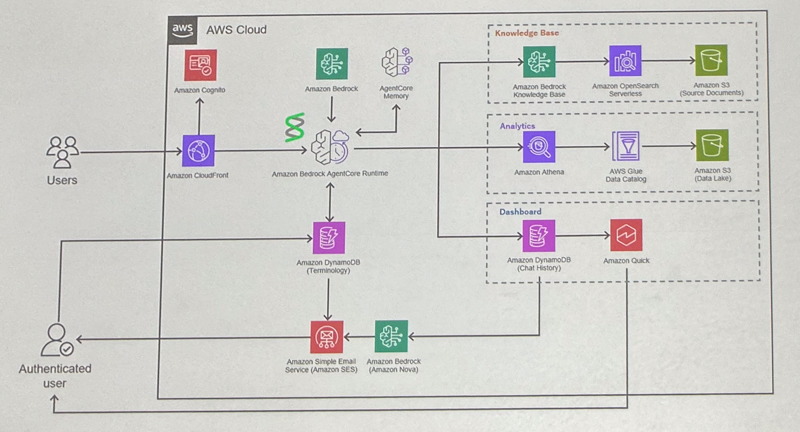
基盤の中核には、AIエージェントの構築・運用基盤「Amazon Bedrock AgentCore」を据えた(図3)。エージェント実行環境であるAgentCore Runtimeを中心に、利用者の認証、回答の生成、対話履歴の記憶、用語辞書の蓄積と管理者への通知、社内文書の検索、利用ログの分析といった役割を各サービスで分担する。