
- UseCase
- 製造
東洋紡、現場が言葉を“教えて育てる”AIエージェントで製造の知見を引き出す
「AWS Summit Japan 2026」より、TX・業務革新総括部の坂倉 広也 氏
人の承認を挟んで用語を蓄積し、対話で問いを整える
再設計の柱の1つが、AI技術の処理に人の判断を介在させる「Human-in-the-loop」による用語の蓄積だ。現場用語を最初から集め切るのは難しく、実際に使う中で初めて出てくる言葉がある。そうした未知の用語はAI技術が候補を提示し、人が承認したうえで用語DBに加える。
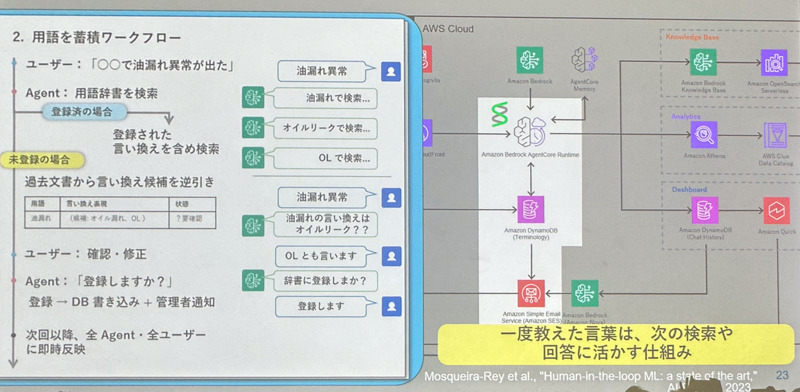
例えば利用者が「R3で油漏れの異常が出た」と入力すると、AIエージェントはまず用語辞書を引く。登録済みの用語なら言い換えを含めてクエリを拡張し、未登録なら過去の文書から候補を逆引きして「油漏れの言い換えはオイルリークか」と問い返す。利用者が「OLとも言う」と返せば、確認を経てDBに書き込み、品質担保のため管理者にも通知する。
用語DBはデータベース「Amazon DynamoDB」上に置く(図4)。AIエージェントは質問を受けるたびに参照することで、書き込んだ用語を次の問い合わせから全利用者の検索に反映する。坂倉氏は「一度教えた言葉を、次の検索や回答に生かす仕組みになった」と強調する。
もう1つの柱が、対話型の検索エージェントだ。クエリ拡張で拾える単語が増えると探索空間も広がり、ノイズも増える。そこで「ざっくりした相談には『いつ・どこで・何が起こったか』を聞き返し、検索前に問いを整える」(坂倉氏)よう工夫する。
内部では自己修正型の自律ループが動く。情報が足りなければ利用者に質問し、検索に進めれば優先度を付けて文書を探す。結果を評価し「十分なら回答を提示し、不十分なら切り口を変えて最大3回まで問い直す」(坂倉氏)
加えて、活用ログによる改善サイクルも回す。エージェントは作って終わりではなく、使われ方から学び続ける必要がある。そこで「チャットログから多い質問や使われている業務フローを分析し、不足しているデータや想定外の業務ニーズを見つけて次の改善に反映する」(坂倉氏)流れにする。
坂倉氏は「課題はコストだった」と話す。ログを人手で監視し続けるのは負担が大きく、一方「高性能モデルで常時処理すればコンテキストを圧迫して費用がかさむ」(同)からだ。
そこで監視に軽量モデル「Amazon Nova(Nova 2 Lite)」を充て、コストを抑えた。ログからは「新しいAIエージェントの立ち上げを検討するきっかけとなる想定外のニーズも見え始めている」と坂倉氏は説明する。
無関心期から実践期へと現場の意識が変わった
現場の要望に合わせた開発の一連の歩みを経て、坂倉氏は生成AI技術に対する現場の意識が「無関心期、関心期、実践期へと移り変わってきた」と過程を振り返り、現在「エージェンティックRAGを製造現場へ展開する実践期へと入っている」(同)とみる。
運用開始から約1か月の先行指標も示した。「関心を持つ利用者数は4人から120人超に増え、利用率は80%を超え、週1回以上使う継続利用率は60%超に達した」(坂倉氏)
さらに有用回答率は70%を上回り、承認済みの独自用語は月に10件以上のペースで増え続けている。坂倉氏は「現場が使い、言葉を教え、知識を残す。その結果AI技術がさらに改善する。そんな循環が生まれてきた」と胸を張る。
この取り組みは単なる検索ツールの導入にとどまらない。「エージェンティックRAG は現場の知識を使える形に変え、属人化の解消に向けた第一歩になった」と坂倉氏は強調する。それは「意識・行動と組織風土をデジタルの力で変えるTXそのもの」(同)だ。
東洋紡が目指す姿を坂倉氏は「現場が主役の世界だ」と話す。「140年の歴史を次の世代へつなげていく。一人ひとりの技術者が培った知識を最大限に生かせるAIエージェントをつくりたい」と締めくくった。